



Doppelte Inhalte und Canonical-URLs vermeiden beim Website-Relaunch
So vermeiden Sie beim Relaunch doppelte Inhalte: Canonical-Tag, 301-Weiterleitung und hreflang richtig einsetzen und Duplikate vor dem Livegang finden.
- Nº
- 28
- Veröffentlicht
- Lesezeit
- 11 Min.
- Kategorie
- Notes
- Geschrieben von
- Revylio
Doppelte Inhalte beim Relaunch vermeiden: eine URL pro Inhalt festlegen
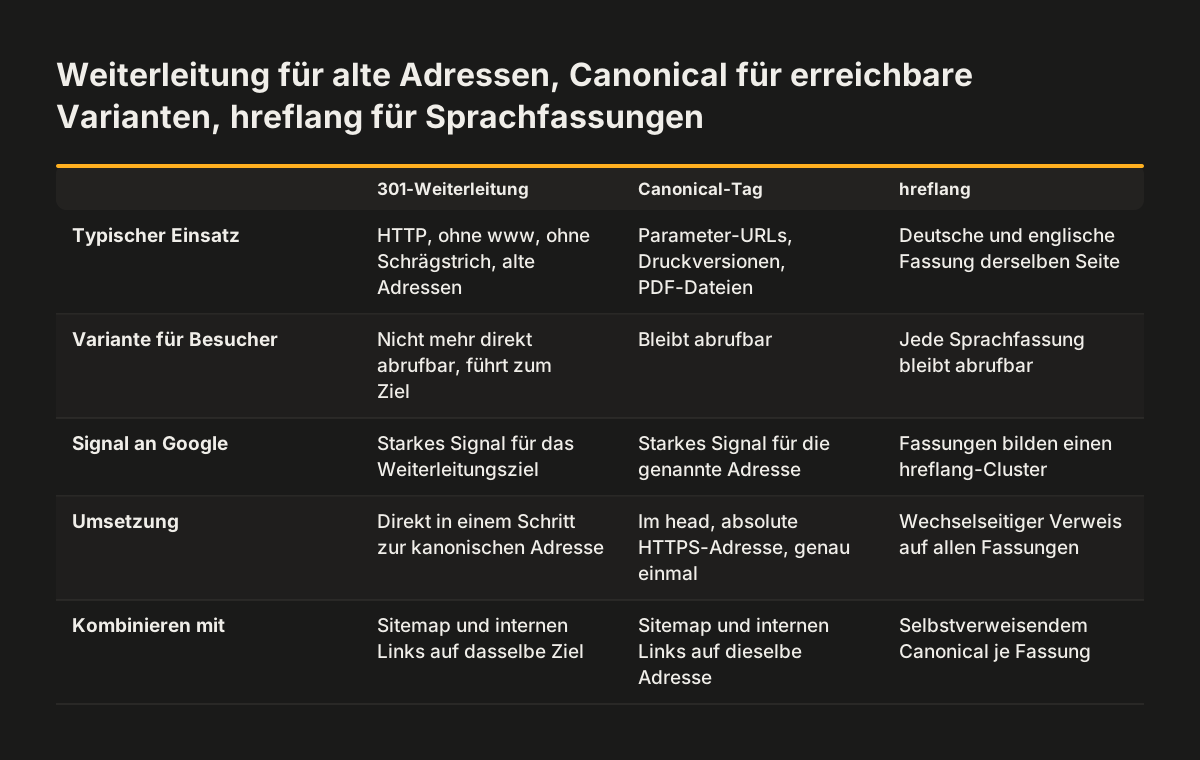
Doppelte Inhalte und Canonical-URLs vermeiden Sie beim Relaunch, indem Sie für jeden Inhalt genau eine Adresse festlegen. Alte und abweichende URLs leiten Sie per 301 dauerhaft auf diese Adresse um. Varianten, die erreichbar bleiben müssen, erhalten ein Canonical-Tag auf diese Adresse. Sprachfassungen verknüpfen Sie mit hreflang.
Doppelte Inhalte (englisch Duplicate Content) sind Inhalte, die unter mehreren URLs abrufbar sind. Die kanonische URL ist die Adresse, die eine Suchmaschine statt der übrigen Varianten als Quelle für die Indexierung heranziehen soll. Das Canonical-Tag ist ein Link-Element mit dem Attribut rel="canonical", das diese bevorzugte Adresse benennt.
Ein Relaunch ist der Zeitpunkt, an dem solche Doppelungen besonders leicht entstehen. Die URL-Struktur ändert sich, alte Adressen bleiben erreichbar, neue Filter erzeugen Parameter, und oft kommt eine zweite Sprache hinzu. Wer die Adressen schon bei der Planung von Seitenstruktur und Navigation festlegt, muss später weniger reparieren.
Dieser Leitfaden erklärt, wie Google zwischen mehreren URLs entscheidet, welche Maßnahme zu welcher Duplikat-Quelle passt und wie Sie Doppelungen vor und nach dem Livegang finden.
Doppelte Inhalte führen nicht zu einer Strafe, aber oft zur falschen URL in den Suchergebnissen
Doppelte Inhalte lösen bei Google offiziell keine Strafe aus. Google selbst sagt laut dem Beitrag von SE Ranking zu doppelten Inhalten, es gebe keine Duplicate Content Penalty. Maßnahmen gegen eine Website folgen nur, wenn die Doppelung offenbar Suchergebnisse täuschen oder manipulieren soll.
Das eigentliche Risiko ist ein anderes: Google filtert Duplikate, statt die Website abzuwerten. Im schlimmsten Fall erscheint dann die weniger gewünschte Version einer Seite im Index. Nach einem Relaunch kann das bedeuten, dass eine alte Adresse, eine Druckversion oder eine URL mit Kampagnen-Parameter in den Suchergebnissen steht. Wer darauf klickt, landet nicht auf der neu gestalteten Seite.
Das Problem ist verbreitet. Matt Cutts, damals bei Google, schätzte laut SE Ranking, dass etwa 25 bis 30 Prozent aller Webinhalte Duplicate Content sind. Ohne eigene Angabe entscheidet Google selbst: Es ermittelt die für Nutzer der Google Suche objektiv beste Version der URL. Diese Wahl muss nicht mit Ihrer übereinstimmen.
Ein weiterer Punkt betrifft das Crawling-Budget. Das Crawling-Budget ist die Begrenzung der Ressourcen, die Suchmaschinen-Roboter für das Crawlen und Indexieren einer Website aufwenden. Canonical-Tags auf gefilterten Seiten lösen dieses Problem laut SE Ranking nicht, denn die Varianten werden weiterhin abgerufen. Eine saubere URL-Struktur beim Relaunch ist deshalb die bessere Grundlage als nachträgliche Korrekturen.
Wo beim Relaunch doppelte URLs entstehen: Protokoll, www, Slash, Parameter, Druck und Sprache
Doppelte URLs entstehen beim Relaunch meist nicht durch kopierte Texte, sondern durch technische Varianten derselben Seite. Suchmaschinen behandeln die Version mit und ohne www als unterschiedliche URLs. Dasselbe gilt für Adressen mit und ohne abschließenden Schrägstrich, selbst wenn beide zur gleichen Seite führen.
Ein durchgerechnetes Beispiel zeigt das Ausmaß. Ein Unternehmen hat nach dem Relaunch die Leistungsseite mit dem Pfad /leistungen/, erreichbar über HTTPS auf der Domain mit www. Ohne Gegenmaßnahmen kann derselbe Inhalt unter diesen Adressen erreichbar sein:
/leistungenüber HTTP auf der Domain ohne www (altes Protokoll, ohne www, ohne Schrägstrich)/leistungen/über HTTPS auf der Domain ohne www/leistungenüber HTTPS mit www (ohne abschließenden Schrägstrich)/leistungen/?utm_source=newsletter(mit Parameter)/leistungen/druck/(Druckversion)/angebot.html(Adresse der alten Website)
Hinzu kommt die englische Fassung unter dem Pfad /en/services/. Sie ist kein Duplikat im engeren Sinn, braucht aber eine eigene Behandlung mit hreflang. Für alle anderen Varianten legt das Unternehmen fest: Die kanonische URL ist die HTTPS-Adresse mit www und dem Pfad /leistungen/. Die folgenden Abschnitte zeigen, welche Variante eine Weiterleitung und welche ein Canonical-Tag erhält.
Bei der Wahl des Protokolls hilft Google mit einer klaren Vorgabe. Google bevorzugt HTTPS-Seiten gegenüber gleichwertigen HTTP-Seiten als kanonische URLs, sofern die HTTPS-Seite keine Probleme hat und sich die Signale nicht widersprechen.
Wie Google die kanonische URL auswählt: starke und schwache Signale
Google wertet mehrere Signale aus, um unter doppelten URLs die kanonische zu bestimmen. Laut Googles Dokumentation zur Kanonisierung doppelter URLs sind Weiterleitungen ein starkes Signal dafür, dass das Ziel der Weiterleitung kanonisch sein sollte. Auch das rel="canonical"-Link-Element ist ein starkes Signal. Die Aufnahme einer URL in die Sitemap ist dagegen nur ein schwaches Signal.
Die Methoden lassen sich kombinieren, und das lohnt sich. Wer zwei oder mehr Methoden verwendet, erhöht nach Google die Wahrscheinlichkeit, dass die bevorzugte kanonische URL in den Suchergebnissen erscheint. Für den Relaunch heißt das: Weiterleitung, Canonical-Tag und Sitemap sollten alle auf dieselbe Adresse zeigen.
Auch ein starkes Signal ist kein Befehl. Google wählt die kanonische URL aus allen Signalen zusammen. Je einheitlicher diese Signale auf dieselbe Adresse zeigen, desto eher übernimmt Google Ihre Wahl.
Ein Grundsatz folgt daraus. Wo eine Variante für Besucher keinen Zweck mehr hat, ist die Weiterleitung das passende Mittel, denn sie führt Besucher und Suchmaschinen gleichermaßen zum Ziel. Das Canonical-Tag ist für Fälle gedacht, in denen die Variante erreichbar bleiben muss, etwa eine Druckversion oder eine URL mit Kampagnen-Parameter.
Verlinken Sie intern immer die kanonische Adresse. Sonst zeigt die eigene Navigation auf eine URL, die Ihr Canonical-Tag gleichzeitig als Duplikat kennzeichnet, und die Signale widersprechen sich.
Canonical-Tag richtig einbauen: im head, mit absoluter URL und genau einmal pro Seite
Das Canonical-Tag wirkt nur, wenn es im head-Abschnitt des HTML-Codes steht. Google akzeptiert das rel="canonical"-Link-Element nach eigener Angabe nur dort. Das folgende Beispiel zeigt die Zeile für die Druckversion aus dem Beispiel. Sie gehört in den head der Seite /leistungen/druck/, in den meisten Systemen also in die Seitenvorlage oder das Feld des SEO-Plugins.
<head>
  <!-- genau ein Canonical-Tag; Platzhalter durch die volle https-Adresse ersetzen -->
  <link rel="canonical" href="KANONISCHE-ADRESSE">
</head>
Ändern müssen Sie nur den Wert von href. Ersetzen Sie den Platzhalter durch die vollständige kanonische Adresse: mit https://, Ihrer Domain mit www und dem Pfad /leistungen/. Ein URL-Fragment mit Rautezeichen gehört nicht hinein, denn Google unterstützt Fragmente in der Regel nicht als kanonische URLs.
Die kanonische Seite selbst trägt dieselbe Zeile. Google nennt das einen selbstverweisenden kanonischen Link: einen rel="canonical"-Link, der der kanonischen Seite selbst hinzugefügt wird.
Prüfen Sie vor dem Einbau, ob Ihr System bereits ein Canonical-Tag ausgibt. Vorlagen und SEO-Plugins setzen es oft selbstständig, und jede Seite sollte genau eines tragen. Welche Funktionen Ihr System dafür mitbringt, hängt von der Wahl ab, die der Beitrag WordPress oder TYPO3 für den Relaunch behandelt.
Für PDF-Dateien funktioniert das Link-Element nicht, weil es nur bei HTML-Seiten greift. Dort kann der Server den rel="canonical"-Hinweis im HTTP-Header übergeben. Google unterstützt diese Methode nur für Websuchergebnisse.
301-Weiterleitungen für alte und abweichende URLs
Eine 301-Weiterleitung ist die richtige Maßnahme für jede URL, die Besucher nicht mehr direkt sehen sollen. Sie beruht auf dem HTTP-Statuscode 301 (Moved Permanently). Sie führt Besucher und Suchmaschinen auf die als Original erklärte URL und unterdrückt die anderen Varianten.
Im Beispiel betrifft das vier Adressen. Die HTTP-Variante, die Variante ohne www, die Variante ohne abschließenden Schrägstrich und die alte Adresse /angebot.html leiten alle direkt auf die HTTPS-Adresse mit www und dem Pfad /leistungen/ weiter. Direkt heißt: in einem Schritt, ohne Zwischenstation über eine weitere Weiterleitung.
Die technische Umsetzung ist für Google zweitrangig. Alle Methoden für dauerhafte Weiterleitungen haben nach Google die gleichen Auswirkungen auf die Google Suche. HTTP-Weiterleitungen, auch serverseitige Weiterleitungen genannt, erzielen laut Google aber die schnellste Wirkung. Weiterleitungen per Skript im Browser sind daher die schwächere Wahl.
Für alte Adressen brauchen Sie eine vollständige Zuordnung von alter zu neuer URL. Wie Sie diese Liste aufbauen und nach dem Umzug prüfen, beschreibt die Checkliste für den Website-Umzug ohne Traffic-Verlust. Wichtig ist, dass keine Weiterleitung auf eine Adresse zeigt, die selbst ein Canonical-Tag auf eine dritte URL trägt. Sonst senden Weiterleitung und Canonical-Tag unterschiedliche Signale.
Sprachvarianten mit hreflang: verknüpfen statt kanonisieren
Sprachfassungen einer Seite verknüpfen Sie mit hreflang und nicht mit einem Canonical-Tag auf die deutsche Seite. Hreflang ist ein Attribut, das Google mitteilt, in welcher Sprache eine Seite vorliegt und welche Fassungen zusammengehören. Laut SE Ranking hilft es Google zu verstehen, dass es sich um lokalisierte Varianten desselben Inhalts handelt.
Google berücksichtigt sogenannte hreflang-Cluster bei der Kanonisierung. Ein hreflang-Cluster sind Seiten, die wechselseitig mit hreflang-Attributen aufeinander verweisen. Google bevorzugt solche URLs. Im Beispiel verweist die deutsche Leistungsseite auf /en/services/ und die englische zurück auf /leistungen/.
Das Canonical-Tag jeder Sprachfassung zeigt auf die eigene Adresse. Würde die englische Seite per Canonical-Tag auf die deutsche verweisen, erklärte sie sich selbst zum Duplikat. Dabei ist sie eine lokalisierte Variante mit eigenem Zweck, und hreflang und Canonical-Tag würden sich widersprechen.
Eine technische Falle gibt es zusätzlich. Ein rel="canonical"-Link, der selbst ein hreflang-, lang-, media- oder type-Attribut trägt, wird von Google nicht für die Kanonisierung verwendet. Halten Sie die Canonical-Zeile und die hreflang-Angaben deshalb in getrennten Link-Elementen.
Häufige Fehler bei der Kanonisierung: robots.txt, noindex und Paginierung
Die meisten Kanonisierungsfehler beim Relaunch entstehen, weil ein Werkzeug für den falschen Zweck eingesetzt wird. Diese Fehler sollten Sie in Ihrer Planung ausschließen:
- robots.txt statt Canonical-Tag: Google rät ausdrücklich davon ab, die robots.txt für die Kanonisierung zu verwenden. Gesperrte URLs kann Google trotzdem indexieren, nur ohne ihren Inhalt.
- Zu frühe Sperre: Blockieren Sie Seiten in der robots.txt, bevor sie erneut gecrawlt wurden, sieht der Crawler laut SE Ranking weder das Canonical-Tag noch eine noindex-Anweisung.
- noindex zur Steuerung: Google rät davon ab, mit noindex die Wahl der kanonischen Seite innerhalb einer Website zu beeinflussen, weil die Seite dadurch vollständig für die Suche blockiert wird.
- Paginierung auf Seite 1 kanonisiert: Paginierte Seiten sind für Google laut SE Ranking keine Duplikate. Ein Canonical-Tag auf die erste Seite würde die Folgeseiten trotzdem als Duplikate kennzeichnen.
Alle vier Fehler haben eine gemeinsame Ursache: Sie senden widersprüchliche oder fehlende Signale. Jede paginierte Seite und jede eigenständige Seite erhält daher einen selbstverweisenden Canonical-Link. Nur echte Varianten verweisen auf eine andere Adresse.
Entscheidungstabelle: welche Maßnahme zu welcher Duplikat-Quelle passt
Die passende Maßnahme hängt davon ab, ob eine Variante für Besucher erreichbar bleiben muss. Die Tabelle fasst die Fälle aus dem Beispiel zusammen und nennt jeweils den Grund.
| Duplikat-Quelle | Maßnahme | Grund |
|---|---|---|
| HTTP statt HTTPS | 301-Weiterleitung auf HTTPS | Google bevorzugt HTTPS als kanonische URL |
| Mit und ohne www | 301-Weiterleitung auf eine Variante | Suchmaschinen werten beide als getrennte URLs |
| Mit und ohne Schrägstrich am Ende | 301-Weiterleitung auf eine Variante | Beide Formen gelten als separate URLs |
| Adressen der alten Website | 301-Weiterleitung auf die neue Seite | Starkes Signal für das Weiterleitungsziel |
| URL mit Kampagnen-Parameter | Canonical-Tag auf die Seite ohne Parameter | Link muss für Auswertungen funktionieren |
| Druckversion | Canonical-Tag auf die Hauptseite | Variante bleibt für Besucher nutzbar |
| Sprachfassung | Selbstverweisendes Canonical-Tag plus hreflang | Lokalisierte Variante, kein Duplikat |
| PDF-Datei mit HTML-Gegenstück | Canonical-Hinweis im HTTP-Header | Link-Element wirkt nur in HTML |
| Paginierte Seiten | Selbstverweisendes Canonical-Tag | Google wertet sie nicht als Duplikate |
Ergänzend gilt für alle Zeilen: Nehmen Sie nur kanonische Adressen in die Sitemap auf. Die Sitemap ist zwar nur ein schwaches Signal, sie sollte den stärkeren Signalen aber nicht widersprechen.
Doppelte Inhalte finden: Prüfschritte vor und nach dem Livegang
Doppelte Inhalte finden Sie am zuverlässigsten mit einer festen Reihenfolge von Prüfschritten. Diese Schritte decken die Quellen aus dem Beispiel ab:
- Staging-Umgebung schützen: Sichern Sie die Testversion mit HTTP-Authentifizierung. Der Googlebot erhält dann den Statuscode 401, und Google indexiert keine URLs mit 4XX-Statuscodes.
- Varianten im Browser aufrufen: Rufen Sie jede wichtige Seite mit HTTP, ohne www und ohne abschließenden Schrägstrich auf. Jede Variante muss in einem Schritt auf die kanonische Adresse weiterleiten.
- Quelltext prüfen: Öffnen Sie den Quelltext jeder Seitenvorlage und suchen Sie nach rel="canonical". Es muss genau ein Treffer im head stehen, mit absoluter HTTPS-Adresse.
- Varianten mit Parameter und Druckversion testen: Das Canonical-Tag dieser Varianten muss auf die Hauptseite zeigen.
- Sprachfassungen gegenprüfen: Jede Fassung verweist per hreflang auf die anderen und per Canonical-Tag auf sich selbst.
- Nach dem Livegang auswerten: Prüfen Sie in der Google Search Console, welche URL Google tatsächlich als kanonisch gewählt hat.
Den dritten Schritt nehmen wir besonders ernst: Bei Svennis öffnen wir vor jedem Livegang den Quelltext aller neuen Seitenvorlagen und zählen die Canonical-Tags im head, weil Vorlage und SEO-Plugin häufig beide eines ausgeben. Doppelte Angaben fallen sonst erst auf, wenn Google bereits eine andere URL gewählt hat.
Ein Hinweis zur Search Console: Sie erkennt laut SE Ranking keine alternativen Sprachseiten. Die hreflang-Angaben prüfen Sie deshalb gesondert im Quelltext.
Was doppelte URLs für Unternehmen in Deutschland beim Relaunch bedeuten
Für Unternehmen in Deutschland betreffen doppelte URLs vor allem drei Situationen beim Relaunch: den Wechsel auf HTTPS, eine zusätzliche englische Fassung und die Testumgebung vor dem Start. In allen drei Fällen entstehen neue Adressen für bestehende Inhalte, und in allen drei Fällen lassen sich die Doppelungen vorab planen.
Wenn die bisherige Website noch unter HTTP erreichbar ist, gehört die Umstellung auf HTTPS in den Relaunch. Google bevorzugt HTTPS-Seiten als kanonische URLs. Eine durchgehende 301-Weiterleitung von HTTP auf HTTPS macht diese Wahl eindeutig.
Wenn Ihr Unternehmen neben der deutschen auch eine englische Fassung betreibt, braucht jede Seite ein hreflang-Paar und ein eigenes Canonical-Tag. Weil die Search Console alternative Sprachseiten nicht erkennt, fällt ein Fehler dort nicht von selbst auf. Planen Sie die Prüfung der Sprachfassungen daher als festen Schritt vor dem Livegang ein.
Die Testumgebung ist die dritte Quelle. Wird sie ohne Schutz unter einer eigenen Subdomain betrieben, steht derselbe Inhalt unter zwei Adressen im Netz. Die HTTP-Authentifizierung mit Statuscode 401 verhindert, dass Google diese Kopie indexiert.
Ob sich ein Relaunch für Ihre Website überhaupt lohnt, klären Sie vorher anhand der Kriterien im Beitrag wann sich ein Website-Relaunch lohnt.
Nächste Schritte: URL-Liste erstellen, Maßnahmen zuordnen, Ergebnis prüfen
Der erste Schritt ist eine vollständige Liste aller heutigen URLs Ihrer Website. Ordnen Sie jeder alten Adresse die neue kanonische Adresse zu. Legen Sie dabei einmal fest, ob Ihre Website mit oder ohne www und mit oder ohne abschließenden Schrägstrich arbeitet.
Danach weisen Sie jeder Variante eine Maßnahme aus der Entscheidungstabelle zu. Diese Reihenfolge hat sich bewährt:
- Kanonische Adresse für jeden Inhalt festlegen.
- 301-Weiterleitungen für Protokoll, www, Schrägstrich und alte Adressen einrichten.
- Canonical-Tags für Parameter-URLs, Druckversionen und PDF-Dateien setzen.
- hreflang für Sprachfassungen ergänzen, mit selbstverweisendem Canonical-Tag.
- Interne Links und Sitemap auf die kanonischen Adressen umstellen.
- Nach dem Livegang in der Search Console die gewählten kanonischen URLs prüfen.
Wenn Sie diese Schritte nicht selbst umsetzen möchten, finden Sie auf der Seite Website-Relaunch und Webdesign bei Revylio, wie wir einen Relaunch mit sauberer URL-Struktur planen und begleiten.