



XML-Sitemap und robots.txt verständlich erklärt: Aufgaben, Fehler und Prüfung
Was XML-Sitemap und robots.txt steuern, wie sie auf Google und KI-Crawler wirken und wie Sie Relaunch-Fehler wie die übernommene Testsperre finden.
- Nº
- 27
- Veröffentlicht
- Lesezeit
- 11 Min.
- Kategorie
- Notes
- Geschrieben von
- Revylio
XML-Sitemap und robots.txt: was die beiden Dateien steuern
XML-Sitemap und robots.txt verständlich erklärt: Die robots.txt legt fest, welche URLs Suchmaschinen-Crawler abrufen dürfen. Die XML-Sitemap listet die Seiten auf, die Crawler finden sollen. Die eine Datei begrenzt also, die andere weist den Weg. Keine der beiden garantiert, dass eine Seite in der Google-Suche erscheint oder daraus verschwindet.
Ein Crawler ist ein Programm, das Webseiten automatisch abruft und erfasst. Bei Google heißt dieses Programm Googlebot. Crawler finden neue Seiten, indem sie Links auf bereits erfassten Seiten folgen. Sie verbringen laut Microsoft Learn zur Verwaltung von robots.txt und Sitemaps nur begrenzte Zeit und Ressourcen auf einer Website.
Die robots.txt ist eine einfache Textdatei im Stammverzeichnis der Website, mit der Sie Crawlern mitteilen, auf welche URLs sie zugreifen können. Sie folgt dem Robots Exclusion Protocol, das in RFC 9309 standardisiert ist. Eine XML-Sitemap ist eine Datei, die Informationen zu den Seiten, Videos und sonstigen Dateien einer Website angibt und die Beziehungen zwischen ihnen darstellt. Auf einen gemeinsamen Standard für XML-Sitemaps haben sich Google, Yahoo und Microsoft im November 2006 geeinigt. Die offizielle Website dazu ist sitemaps.org.
Beide Dateien richten sich an Maschinen, nicht an Besucher. Ihre Wirkung hängt davon ab, ob der jeweilige Crawler sie liest und befolgt. Genau an dieser Stelle entstehen die meisten Missverständnisse.
Die robots.txt steuert das Crawlen, nicht die Indexierung
Die robots.txt regelt den Abruf von URLs, sie entfernt keine Seiten aus der Google-Suche. Google nennt als Hauptzweck der Datei, eine Überlastung der Website mit Anfragen zu vermeiden. Um eine Seite aus der Suche herauszuhalten, empfiehlt Google stattdessen das noindex-Meta-Tag, einen entsprechenden Antwortheader, einen Passwortschutz oder das vollständige Entfernen der Seite.
Gesperrte Seiten können trotzdem in den Suchergebnissen stehen
Eine per robots.txt gesperrte Seite kann weiterhin indexiert werden, wenn andere Websites auf sie verweisen. Die URL erscheint dann zwar in den Suchergebnissen, aber ohne Beschreibung. Das steht so in der Einführung zu robots.txt bei Google Search Central.
Die robots.txt ist eine Bitte, kein Zugriffsschutz
Crawler sind nicht verpflichtet, die Anweisungen der robots.txt einzuhalten. Der Googlebot und andere seriöse Crawler befolgen sie, andere nicht. Unterschiedliche Crawler interpretieren die Syntax zudem unterschiedlich. Weil die Datei öffentlich ist, schützt sie keine vertraulichen Bereiche vor unbefugtem Zugriff.
noindex in der robots.txt wirkt nicht mehr
Ein noindex-Eintrag in der robots.txt war bis 2019 bei Google möglich, wird aber nicht mehr unterstützt. Gefährlich ist außerdem die Kombination aus Sperre und noindex-Tag auf der Seite selbst. Wenn eine bereits indexierte Seite in der robots.txt gesperrt ist, kann Google das noindex-Tag nicht abrufen. Die Sperre verhindert dann sogar die Entfernung aus dem Index.
Was in eine XML-Sitemap gehört und welche Angaben Google auswertet
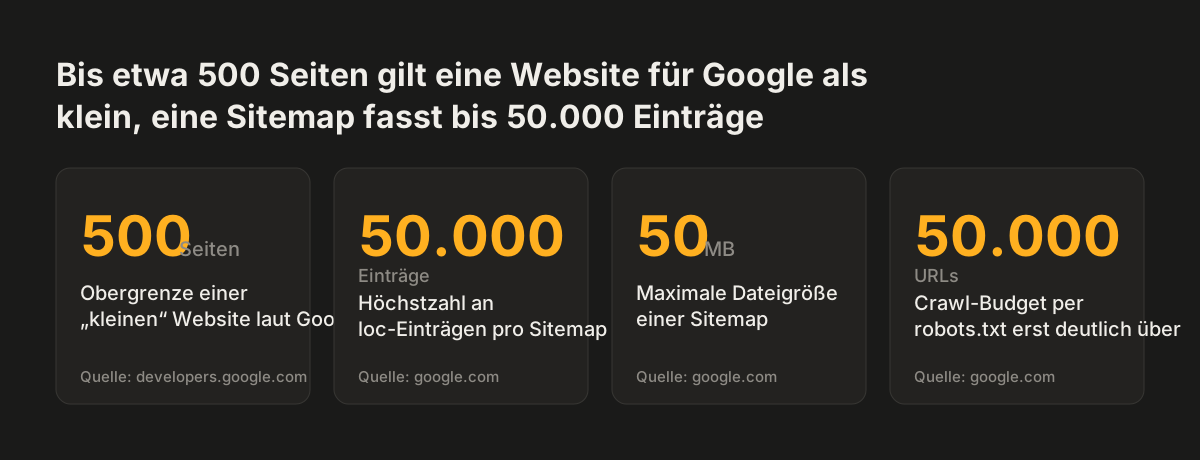
In eine XML-Sitemap gehören die Seiten, die Suchmaschinen finden und indexieren sollen. Jede URL muss vollständig angegeben sein, also mit Protokoll und Domainname, etwa https://www.beispiel-gmbh.de/leistungen. Alle URLs einer Sitemap müssen von einem einzigen Host stammen. Pro Sitemap sind höchstens 50.000 Einträge und 50 MB Dateigröße möglich.
Zusatzangaben, die zählen, und solche, die Google ignoriert
Eine Sitemap kann zu jeder URL Zusatzinformationen liefern. Google ignoriert laut seiner Hilfe die Werte priority und changefreq, also die relative Priorität und die angebliche Änderungshäufigkeit. Den Wert lastmod, das Datum der letzten Änderung, nutzt Google, wenn er konsistent und nachweisbar korrekt ist. Ein automatisch bei jedem Aufruf neu gesetztes Datum hilft deshalb nicht.
Laut der Sitemap-Übersicht bei Google Search Central kann eine Sitemap außerdem diese Angaben enthalten:
- alternative Sprachversionen einer Seite
- für Videos die Laufzeit, die Bewertung und die Alterseignung
- für Nachrichten den Artikeltitel und das Veröffentlichungsdatum
Bei Bilder-Sitemaps wertet Google seit Mai 2022 nur noch die Pflichtangaben image:image und image:loc aus.
Format, Name und Aufteilung
Der Dateiname einer Sitemap ist frei wählbar. Google verarbeitet neben XML auch Atom, RSS und einfache .txt-Dateien. Mehrere Sitemaps fassen Sie in einer Sitemap-Indexdatei zusammen, die auf die einzelnen Dateien verweist. Eine Garantie, dass alle aufgeführten URLs indexiert werden, gibt es nicht.
Ob Ihre Website eine XML-Sitemap braucht: Googles Grenze von etwa 500 Seiten
Eine XML-Sitemap ist keine Pflicht, für viele Unternehmenswebsites aber sinnvoll. Google findet nach eigener Aussage den größten Teil einer Website, wenn ihre Seiten richtig verlinkt sind. Eine Sitemap hilft vor allem bei größeren oder komplexeren Websites und bei stärker spezialisierten Dateien.
Wann Google eine Sitemap empfiehlt
Google nennt mehrere Fälle, in denen eine Sitemap das Crawling verbessert:
- Die Website ist groß, sodass der Googlebot neue Seiten eher übersieht.
- Die Website ist neu, und kaum andere Websites verweisen auf sie.
- Die Website enthält viele Videos und Bilder oder erscheint in Google News.
Wann eine Sitemap unter Umständen entbehrlich ist
Eine kleine Website braucht laut Google unter Umständen keine Sitemap. Als klein gilt eine Website mit etwa 500 oder weniger Seiten, die in Suchergebnissen erscheinen sollen. Zusätzlich muss sie intern umfassend verlinkt sein. Das heißt, der Googlebot findet alle wichtigen Seiten über Links von der Startseite aus.
In der Praxis erzeugen viele Website-Baukästen die Sitemap ohnehin selbst. Die Sitejet-Hilfe zur sitemap.xml beschreibt etwa, dass Sitejet Studio die Datei automatisch erstellt und bei Änderungen aktualisiert. Anpassen lässt sie sich dort nicht. Die Funktion gilt laut Hilfe nur für Sitejet Studio, nicht für den Sitejet Builder über cPanel oder Plesk. Wer einen Baukasten nutzt, sollte also prüfen, ob die automatische Sitemap im eigenen Tarif tatsächlich entsteht.
Quelle: developers.google.com, google.com
Welches Mittel für welches Ziel: robots.txt, noindex, Passwort oder Sitemap
Für jedes Ziel gibt es ein passendes Werkzeug, und die robots.txt ist nur selten das richtige für Fragen der Sichtbarkeit. Die folgende Tabelle ordnet typische Vorhaben einer Unternehmenswebsite dem geeigneten Mittel zu. Grundlage sind die Angaben von Google, Microsoft und mindshape aus den Quellen dieses Beitrags.
| Ziel | Geeignetes Mittel | Begründung |
|---|---|---|
| Seite soll nicht in der Google-Suche erscheinen | noindex-Meta-Tag oder Antwortheader, Seite crawlbar lassen | Eine robots.txt-Sperre verhindert die Indexierung nicht zuverlässig. |
| Testumgebung oder interner Bereich soll nicht öffentlich sein | Passwortschutz auf dem Server | Die robots.txt ist öffentlich und bietet keinen Schutz vor Zugriff. |
| Crawler sollen Anmelde- oder Ressourcenseiten gar nicht erst anfordern | Disallow-Regel in der robots.txt | Das Vermeiden unnötiger Anfragen ist der Hauptzweck der Datei. |
| Neue oder schwach verlinkte Seiten sollen gefunden werden | XML-Sitemap, eingereicht in der Google Search Console | Die Sitemap erleichtert das Auffinden wenig verlinkter oder tief verschachtelter Seiten. |
| Bild-, Video- oder Audiodateien sollen nicht in den Google-Ergebnissen erscheinen | Disallow-Regel in der robots.txt | Laut Google möglich, andere können aber weiterhin auf die Dateien verlinken. |
| Seite soll endgültig verschwinden | Seite vollständig entfernen | Google nennt das Entfernen ausdrücklich als Weg aus den Suchergebnissen. |
Eine Regel folgt daraus direkt: Kombinieren Sie noindex nicht mit einer Sperre in der robots.txt. Der Crawler muss die Seite abrufen können, um das noindex-Tag überhaupt zu sehen.
KI-Crawler in der robots.txt: GPTBot, PerplexityBot und Google-Extended
KI-Anbieter betreiben mehrere Crawler mit unterschiedlichen Aufgaben, und die robots.txt kann jeden davon einzeln ansprechen. Regeln mit Allow und Disallow lassen sich für alle Crawler oder für einen bestimmten User-Agent festlegen. Der User-Agent ist die Kennung, mit der sich ein Crawler beim Abruf ausweist.
Welche KI-Crawler was tun
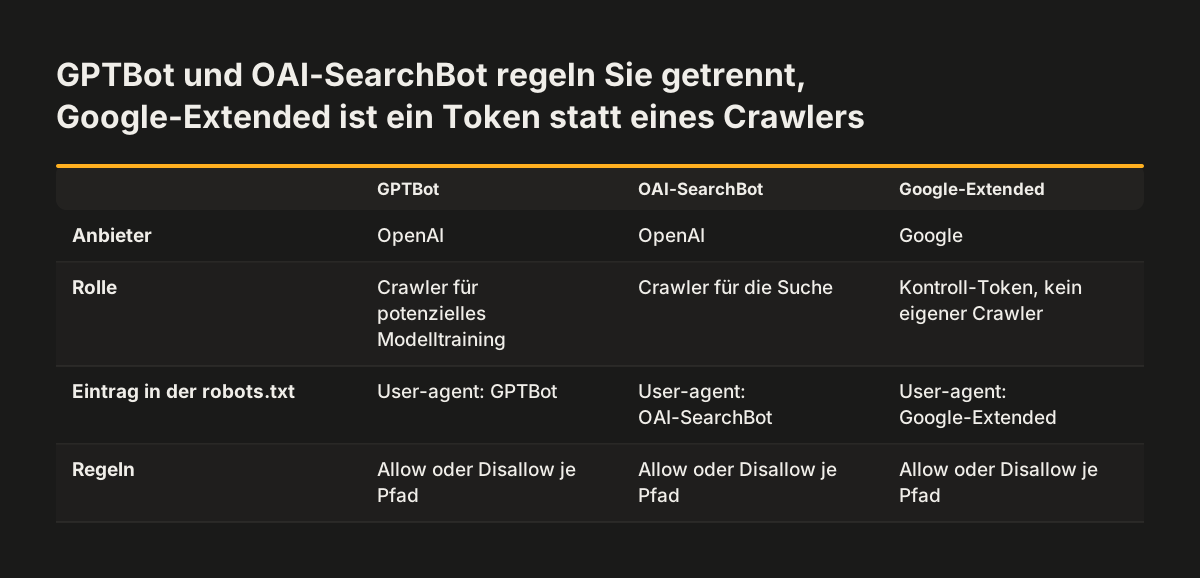
Ein Vergleich von llms.txt und robots.txt fasst die Angaben der Anbieter zusammen:
- OpenAI nutzt GPTBot für potenzielles Modelltraining, OAI-SearchBot für die Suche und ChatGPT-User für Abrufe, die ein Nutzer auslöst.
- Perplexity nutzt PerplexityBot für Suchfunktionen und Perplexity-User für nutzerinitiierte Abrufe.
- Google-Extended ist ein Kontroll-Token, kein eigener Crawler. Laut Google beeinflusst diese Einstellung weder die Aufnahme noch das Ranking in der klassischen Google-Suche.
Für Abrufe, die ein Nutzer auslöst, greifen robots.txt-Regeln laut den Anbietern nicht immer auf dieselbe Weise wie beim automatischen Crawling.
Beispiel: Modelltraining sperren, Suche erlauben
Die folgende robots.txt sperrt nur GPTBot und lässt alle anderen Crawler zu. Sie gehört als Datei robots.txt ins Stammverzeichnis Ihrer Live-Domain.
User-agent: GPTBot
Disallow: /

User-agent: *
Disallow:

Sitemap: https://www.beispiel-gmbh.de/sitemap.xml
Ändern müssen Sie den Namen des Crawlers in der ersten Zeile und die Domain in der Sitemap-Zeile. Das leere Disallow in der zweiten Gruppe verbietet nichts. Die llms.txt, ein offener Formatvorschlag für eine Markdown-Liste wichtiger Seiten, ersetzt diese Regeln nicht. Sie ist kein verabschiedeter Standard und kennt keine Anweisungen gegen KI-Training.
Beispiel: die aus der Testumgebung übernommene Sperre in der robots.txt
Der häufigste Relaunch-Fehler bei der robots.txt ist eine Komplettsperre, die aus der Testumgebung auf die Live-Website gelangt. Das folgende Beispiel zeigt den Ablauf an einer fiktiven Beispiel GmbH. Deren neue Website entsteht zunächst auf der Subdomain test.beispiel-gmbh.de.
So entsteht der Fehler
Damit Google die Testumgebung nicht erfasst, erhält sie eine robots.txt mit diesem Inhalt:
User-agent: *
Disallow: /
Der Stern steht als Platzhalter für alle Crawler. Disallow: / untersagt innerhalb dieser Gruppe das Crawlen aller Pfade. Beim Livegang kopiert das Team alle Dateien auf www.beispiel-gmbh.de, die robots.txt eingeschlossen. Ab diesem Moment bittet die neue Website jeden seriösen Crawler, keine einzige Seite abzurufen.
Google kann auf der Live-Website dann neue Inhalte, Titel und noindex-Angaben nicht mehr lesen. Bereits verlinkte URLs erscheinen im ungünstigen Fall ohne Beschreibung in den Suchergebnissen.
So beheben Sie ihn
Auf der Live-Domain ersetzen Sie die Datei durch die Fassung mit leerem Disallow und Sitemap-Zeile aus dem vorigen Abschnitt. Die Testumgebung schützen Sie stattdessen mit einem Passwort, wie Google es für nicht öffentliche Bereiche empfiehlt. Eine robots.txt gilt ohnehin nur für genau einen Host, die Subdomain braucht also ihre eigene Datei.
Bei Svennis gleichen wir deshalb am Tag der Freischaltung die robots.txt der Live-Domain Zeile für Zeile ab, bevor wir die Sitemap in der Search Console einreichen. Die übernommene Komplettsperre finden wir bei Websites, die wir nach einem fremden Relaunch übernehmen, immer wieder.
Weitere typische Fehler, die Seiten vor der Google-Suche verstecken
Neben der Komplettsperre verstecken einige kleinere Fehler in robots.txt und XML-Sitemap Seiten vor der Suche, oft unbemerkt. Die meisten davon betreffen Dateiname, Speicherort oder einzelne Regeln. Die folgenden Fehler beschreiben Google, mindshape, OMR Reviews und die Sitejet-Hilfe:
- Falscher Speicherort: Suchmaschinen erwarten die Datei nur unter ihre-domain.de/robots.txt. Liegt sie woanders, nimmt der Crawler an, dass keine Einschränkungen bestehen.
- Großbuchstaben im Dateinamen: Heißt die Datei Robots.txt, haben ihre Anweisungen keine Wirkung.
- Gesperrte CSS- und JavaScript-Dateien: Google braucht diese Dateien, um die Seite sauber darzustellen. Fehlen sie, versteht der Crawler die Seite schlechter.
- Crawl-delay als Bremse: Die Anweisung für eine Verzögerung zwischen zwei Abrufen befolgt Google nicht.
- Relative URLs in der Sitemap: Jeder Eintrag braucht Protokoll und Domainname.
- Versehentlich ausgeblendete Seiten: Im Sitejet-Baukasten fehlen eine Seite und ihre Unterseiten in der Sitemap, wenn das Häkchen bei „Menü“ entfernt ist.
Für sehr große Websites kommt die Frage des Crawl-Budgets hinzu. Das Crawl-Budget ist die Menge an Seiten, die eine Suchmaschine auf einer Website durchsucht. Eine gezielte Steuerung per robots.txt ist laut mindshape aber erst bei deutlich mehr als 50.000 URLs relevant. Für die typische Unternehmenswebsite spielt das keine Rolle.
robots.txt und XML-Sitemap prüfen: Checkliste in sechs Schritten
Beide Dateien prüfen Sie ohne Spezialwerkzeug im Browser und in der Google Search Console. Die Search Console ist Googles kostenloses Werkzeug für Websitebetreiber, früher Webmaster Tools genannt. Gehen Sie nach jedem Relaunch und nach größeren Updates diese Schritte durch:
- Rufen Sie https://www.ihre-domain.de/robots.txt im Browser auf. Unter User-agent: * darf kein Disallow: / stehen.
- Prüfen Sie, ob die robots.txt eine Zeile mit der Sitemap-URL enthält. Microsoft nennt diesen Eintrag den einfachsten Weg, Suchmaschinen über den Speicherort der Sitemap zu informieren.
- Öffnen Sie die Sitemap unter der dort genannten Adresse, häufig /sitemap.xml. Jede URL muss mit https und Ihrer Domain beginnen.
- Stichprobe: Öffnen Sie einige URLs aus der Sitemap. Sie sollten erreichbar sein und kein noindex tragen.
- Reichen Sie die Sitemap in der Google Search Console unter Indexierung und dann Sitemaps ein. Für Bing nutzen Sie die Bing Webmaster Tools.
- Die robots.txt selbst reichen Sie nirgends ein. Google ruft sie von sich aus ab.
Wer seine Website auf einem Windows-Server mit IIS 7 oder höher betreibt, kann beide Dateien auch über das IIS Search Engine Optimization Toolkit pflegen. Es enthält laut Microsoft eine Funktion für die robots.txt sowie eine für Sitemaps und Sitemap-Indizes. Das Toolkit setzt eine gehostete Website oder Webanwendung voraus, die Sie selbst steuern.
Was das für Unternehmen in Deutschland bedeutet: Sprachversionen, Umlaute und Subdomains
Für Unternehmenswebsites in Deutschland betreffen robots.txt und XML-Sitemap vor allem drei Punkte: mehrsprachige Inhalte, Umlaute in Adressen und zusätzliche Subdomains. Alle drei entstehen bei einem Relaunch häufig neu.
Deutsche und englische Seiten in einer Sitemap
Viele Mittelständler bieten ihre Website auf Deutsch und Englisch an. Eine Sitemap kann laut Google Angaben zu alternativen Sprachversionen einer Seite enthalten. Diese Angabe heißt hreflang und teilt Suchmaschinen mit, unter welcher URL derselbe Inhalt in einer anderen Sprache steht. Bei Sitejet liegt die Sitemap auch bei mehrsprachigen Websites unter der Hauptadresse. Erweiterungen wie /de oder /en lassen Sie beim Aufruf weg.
Umlaute und ß in Adressen
Wer Pfade wie /über-uns oder /größen verwendet, braucht eine korrekte Zeichencodierung. Die robots.txt muss UTF-8-codiert sein, für die XML-Sitemap gilt dieselbe Empfehlung. Andernfalls passen Regeln und Einträge im Zweifel nicht zu den tatsächlichen Adressen.
Eigene Dateien für Karriere-, Shop- und Testbereiche
Eine robots.txt gilt nur für genau ein Protokoll, einen Host und einen Port. Regeln auf www.beispiel-gmbh.de gelten also nicht für karriere.beispiel-gmbh.de. Auch eine Sitemap darf nur URLs eines Hosts enthalten. Jede Subdomain braucht deshalb eigene Dateien, und jede Testumgebung braucht einen Passwortschutz statt einer Bitte an die Crawler.
Nächste Schritte für die robots.txt und XML-Sitemap Ihrer Website
Der schnellste Nutzen dieses Leitfadens ist eine Prüfung der Live-Website, die Sie heute selbst durchführen können. Sie dauert bei einer typischen Unternehmenswebsite nicht lange und braucht nur einen Browser und den Zugang zur Search Console.
- Öffnen Sie die robots.txt Ihrer Domain und suchen Sie nach Disallow: / in der Gruppe für alle Crawler. Steht die Zeile dort, entfernen Sie sie oder lassen Sie sie von Ihrem Dienstleister entfernen.
- Entscheiden Sie bewusst über KI-Crawler. Legen Sie fest, ob Sie Trainings-Crawler wie GPTBot sperren und Such-Crawler wie OAI-SearchBot zulassen wollen. Tragen Sie die Regeln dann je User-Agent in die robots.txt ein.
- Prüfen Sie, ob Ihre Sitemap existiert, vollständige URLs enthält und in der Google Search Console eingereicht ist.
- Kontrollieren Sie Seiten, die nicht in der Suche erscheinen sollen. Sie brauchen ein noindex-Tag und dürfen nicht gleichzeitig in der robots.txt gesperrt sein.
- Planen Sie für den nächsten Relaunch einen festen Prüfpunkt am Tag der Freischaltung ein, an dem jemand robots.txt und Sitemap der Live-Domain abgleicht.
Halten Sie das Ergebnis schriftlich fest, etwa als kurze Notiz mit Datum und gefundenen Regeln. Damit lässt sich nach dem nächsten Update schnell erkennen, ob sich an einer der beiden Dateien etwas verändert hat.
Quellen
- Google Search Central: Einführung und Leitfaden zu robots.txt-Dateien
- Google Search Central: Was ist eine Sitemap?
- Microsoft Learn: Verwalten von Robots.txt- und Sitemap-Dateien
- mindshape: robots.txt, alles, was Sie als SEO darüber wissen müssen
- llms.txt vs. robots.txt: Unterschiede, Beispiele und Einsatz
- OMR Reviews: Sitemaps von A bis Z
- Sitejet Hilfe: Eine sitemap.xml-Datei für deine Website