Crawlerele AI în robots.txt: cum decideți ce blocați și ce permiteți
Cum decideți, crawler cu crawler, ce boți AI permiteți în robots.txt, ca să apăreți în căutarea AI fără să cedați conținutul pentru antrenare.
- Nº
- 33
- Publicat
- Lectură
- 10 min
- Categorie
- Notes
- Scris de
- Revylio
Crawlerele AI în robots.txt: decideți separat pentru căutare și pentru antrenare
La întrebarea „crawlerele AI: blocați sau permiteți în robots.txt”, răspunsul scurt este: decideți pentru fiecare crawler în parte, după produsul pe care îl alimentează. Pe Googlebot îl permiteți, pentru că de el depinde Google Search. Google-Extended îl blocați doar dacă nu vreți ca Google să vă folosească conținutul pentru modelele Gemini. Blocarea lui nu vă scoate din Google Search.
Un crawler AI este un program automat care accesează paginile unui site ca să aducă conținut unui sistem de inteligență artificială, pentru antrenarea unui model sau pentru răspunsuri generate. Fișierul robots.txt este fișierul care le spune crawlerelor ce adrese URL de pe site pot accesa. Un user agent este numele cu care se prezintă un crawler; în robots.txt îl folosiți ca să adresați reguli unui robot anume.
Robots.txt rămâne o cerere. Googlebot și crawlerele de încredere respectă regulile din fișier, dar alte crawlere pot să nu le respecte. De aceea fișierul este un instrument de preferință, nu de protecție.
Ghidul acesta vă arată ce poate și ce nu poate face fișierul, ce controlează fiecare user agent Google, inclusiv Google-Extended, și cum arată un fișier care separă căutarea de folosirea conținutului pentru AI.
Ce poate și ce nu poate face robots.txt
Robots.txt este o cerere, nu un zid. Googlebot și alte crawlere de încredere respectă regulile din fișier, dar alte crawlere pot să nu le respecte. Google mai precizează că fiecare crawler poate interpreta regulile în felul său. Rolul principal al fișierului, spune Google, este să împiedice un crawler să trimită prea multe cereri către site.
Robots.txt nu ascunde o pagină de Google. Google poate găsi și indexa un URL blocat dacă alte pagini de pe web trimit spre el. Rezultatul apare atunci în căutare, dar fără descriere.
Ca să scoateți cu adevărat o pagină din rezultatele Google, documentația Google indică trei metode:
- protejați fișierele de pe server cu parolă;
- folosiți eticheta meta noindex sau antetul de răspuns echivalent;
- ștergeți pagina.
Aceeași limită se aplică oricărui crawler AI. Google avertizează că unele motoare de căutare pot să nu susțină deloc regulile din robots.txt. Conținutul pe care nu vreți să îl vadă nimeni din afară stă în spatele unei parole, nu doar în spatele unei linii Disallow. Detaliile sunt în introducerea Google despre fișierul robots.txt.
Pentru fișierele media, robots.txt are un efect mai direct. Puteți împiedica imaginile, videoclipurile și fișierele audio să apară în rezultatele Google. Fișierul nu oprește însă alte site-uri sau alți utilizatori să trimită linkuri către ele.
Reguli pentru fiecare crawler: cum adresați un user agent în robots.txt
Robots.txt funcționează pe grupuri de reguli. Fiecare grup începe cu o linie User-agent, care numește crawlerul, și continuă cu regulile Allow sau Disallow pentru el. Așa puteți trata diferit un robot de căutare și un robot care adună conținut pentru AI, în același fișier.
Unele crawlere au mai multe token-uri de user agent. Google precizează că ajunge să potriviți unul singur ca regula să se aplice. Pentru Google-Extended, numele pe care îl scrieți în robots.txt este chiar token-ul de produs.
Interpretarea regulilor nu este uniformă. Google avertizează că fiecare crawler poate interpreta regulile în felul său, iar unele motoare de căutare nu le susțin deloc. Un fișier simplu, cu grupuri clare și puține excepții, lasă mai puțin loc de interpretare.
Aceeași logică pentru orice crawler AI
Pentru orice crawler AI pe care vreți să îl tratați separat, scrieți un grup cu numele lui exact. În grupul respectiv puneți doar ce are voie să acceseze. Numele exact contează: un grup scris cu un nume greșit nu se adresează niciunui robot, iar crawlerul vizat urmează mai departe regulile generale.
User agent-urile Google și ce controlează fiecare
Google folosește mai mulți crawleri comuni, fiecare cu alt nume în robots.txt și cu alt produs controlat. Crawlerele comune Google respectă întotdeauna regulile robots.txt când accesează automat un site. Lista publicată de Google nu este exhaustivă: acoperă doar crawlerele care apar cel mai des în jurnalele serverului.
User agent-urile Google pe care le întâlniți cel mai des sunt acestea:
- Googlebot: regulile pentru el afectează Google Search, inclusiv Discover și toate funcțiile căutării, plus Google Images, Video mode și Google News.
- Googlebot-News: nu are un user agent HTTP separat; accesarea se face cu diverse user agent-uri Googlebot.
- Storebot-Google: regulile pentru el afectează toate suprafețele Google Shopping.
- Google-InspectionTool: afectează instrumentele de test, precum Rich Result Test și inspecția URL din Search Console, fără efect asupra Google Search.
- Google-CloudVertexBot: afectează accesările cerute de proprietarii site-urilor pentru construirea de agenți Vertex AI, fără efect asupra Google Search.
- Google-Extended: token pentru modelele Gemini, explicat în secțiunea următoare.
Unele crawlere Google au mai multe token-uri de user agent. Pentru ca o regulă să se aplice, ajunge să potriviți unul dintre ele. Detaliile complete sunt în pagina Google despre crawlerele comune Google.
Google-Extended controlează folosirea conținutului pentru Gemini, nu Google Search
Google-Extended este un token de produs separat, fără user agent HTTP propriu, pe care îl folosiți doar în robots.txt. Prin el decideți dacă Google poate folosi conținutul accesat pe site-ul dumneavoastră pentru antrenarea generațiilor viitoare de modele Gemini. Același token controlează și folosirea conținutului pentru grounding în Gemini Apps și în Grounding with Google Search pe Vertex AI.
Grounding înseamnă că modelul primește, în momentul întrebării, conținut din indexul Google Search, ca răspunsul să fie mai corect și mai relevant. Dacă blocați Google-Extended, conținutul dumneavoastră nu mai este folosit nici la antrenarea Gemini, nici la acest grounding. Acesta este costul real al blocării.
Google-Extended nu influențează includerea site-ului în Google Search. Google spune explicit că nu este nici semnal de poziționare în căutare. Blocarea lui nu schimbă felul în care Google Search accesează site-ul.
Pentru o firmă, regula practică este simplă. Blocarea Google-Extended este o decizie despre Gemini, nu despre poziția în Google. Apariția în rezumatele generate de AI din pagina de rezultate Google este un subiect separat. Îl tratăm în ghidul despre ce trebuie să repare site-ul ca să fie citat în Google AI Overviews.
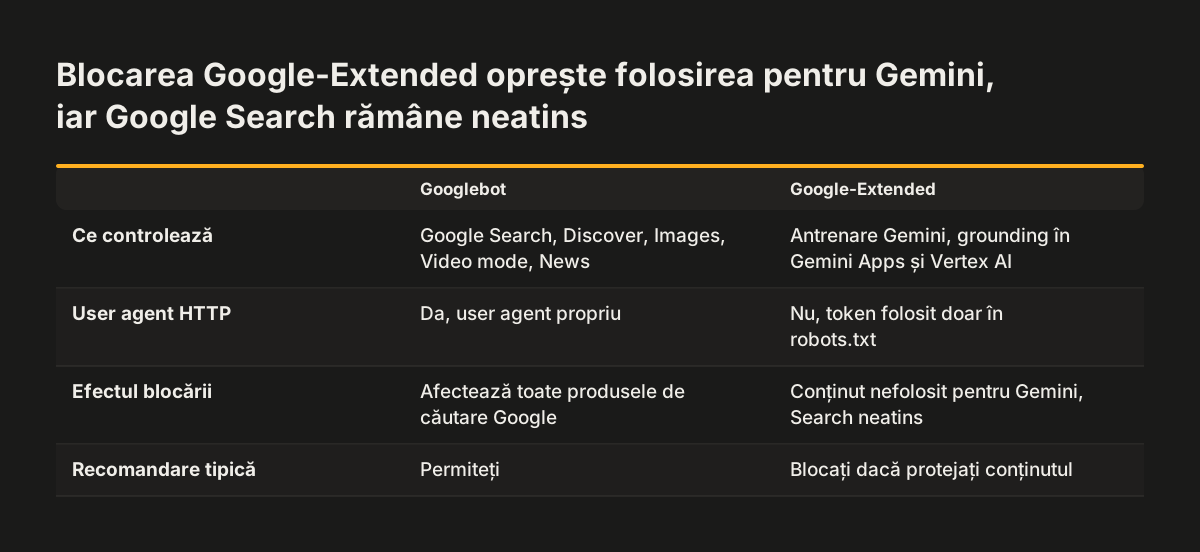
Tabelul de decizie pentru crawlerele Google, inclusiv cele pentru AI
Tabelul de mai jos rezumă decizia pentru crawlerele Google pe care le întâlniți cel mai des. Coloana de recomandare se potrivește unei firme care vrea să rămână vizibilă în Google, dar nu vrea ca Google să îi folosească conținutul pentru Gemini.
| Crawler | Ce controlează | Efectul blocării | Recomandare tipică |
|---|---|---|---|
| Googlebot | Google Search, Images, News, Discover | Afectează toate produsele de căutare Google | Permiteți |
| Google-Extended | Antrenare Gemini și grounding | Conținutul nu e folosit pentru Gemini; Search rămâne neatins | Blocați dacă protejați conținutul |
| Storebot-Google | Toate suprafețele Google Shopping | Afectează prezența în Google Shopping | Permiteți dacă vindeți produse |
| Google-CloudVertexBot | Agenți Vertex AI ceruți de proprietar | Fără efect asupra Google Search | Lăsați neschimbat |
| Google-InspectionTool | Rich Result Test și inspecția URL | Instrumentele de test nu mai citesc paginile; Search rămâne neatins | Permiteți |
Recomandarea se schimbă după tipul de conținut. Paginile de servicii, de contact și studiile de caz sunt făcute să fie citite și citate. Ghidurile detaliate pe care le vindeți sau care vă diferențiază pot justifica blocarea Google-Extended.
Exemplu lucrat: robots.txt care păstrează Google Search și refuză Gemini
Exemplul pornește de la o firmă de servicii cu blog public și o zonă de cont pentru clienți la adresa /cont/. Firma vrea să apară în Google Search, nu vrea ca Google să îi folosească conținutul pentru Gemini și vrea ca zona de cont să nu fie accesată. Fișierul de mai jos face exact asta. Îl salvați ca robots.txt la rădăcina domeniului, adică la adresa domeniului urmată de /robots.txt.
# Refuza folosirea continutului pentru modelele Gemini
User-agent: Google-Extended
Disallow: /

# Toate celelalte crawlere, inclusiv Googlebot
User-agent: *
Disallow: /cont/
Primul grup se adresează doar token-ului Google-Extended și îi cere să nu folosească nimic de pe site. Al doilea grup se adresează celorlalte crawlere, inclusiv Googlebot, care nu are aici un grup propriu. Ele pot accesa tot site-ul, mai puțin zona /cont/. Google Search rămâne neatins, pentru că Google-Extended nu influențează includerea în căutare.
Liniile pe care le schimbați sunt căile. Înlocuiți /cont/ cu directorul pe care vreți să îl excludeți și adăugați câte o linie Disallow pentru fiecare director în plus. Pentru alt crawler AI, adăugați un grup nou cu numele lui exact. Nu blocați directoarele cu fișiere CSS și JavaScript, pentru că fără ele Google nu poate analiza corect paginile.
Zona de cont trebuie oricum protejată cu parolă. Robots.txt rămâne o cerere, iar un URL blocat poate apărea totuși în căutare, fără descriere, dacă alte pagini trimit spre el.
Ce oprește un crawler chiar dacă robots.txt îl permite
Un robots.txt corect nu garantează accesul unui crawler. Pagina de ajutor Google despre problemele crawlerului de anunțuri AdMob descrie mai multe obstacole din afara fișierului. Sunt scrise pentru crawlerul de anunțuri, dar merită verificate pentru orice crawler pe care l-ați permis:
- Paginile cu autentificare: crawlerul poate fi redirecționat către pagina de conectare și nu vede conținutul.
- Restricțiile geografice sau pe intervale de IP: pot împiedica crawlerul să acceseze adresele URL.
- Serverul lent sau supraîncărcat: poate să nu răspundă la timp dacă este inactiv, încet sau a primit prea multe cereri.
- Redirecționările multiple: pierderea unor parametri precum cookie-urile pe drum reduce calitatea accesării.
- Conținutul servit prin POST: crawlerul de anunțuri nu trimite date POST, iar Google recomandă o cerere GET pentru conținutul generat dintr-un formular.
- Resursele blocate: dacă blocați fișierele de care are nevoie pagina, Google nu o poate analiza corect.
Concluzia practică: verificați robots.txt împreună cu setările de securitate ale găzduirii. La Svennis citim fișierul robots.txt alături de regulile firewall-ului de la găzduire, pentru că vedem des site-uri care permit un crawler în fișier și îl resping la nivel de server. Proprietarul crede că a permis accesul, dar robotul nu ajunge niciodată la pagini.
Testul simplu este jurnalul serverului. Dacă un crawler permis în robots.txt nu apare în jurnale sau primește doar erori, problema nu este în fișier.
Ce înseamnă alegerea crawlerelor AI pentru o firmă din România
Pentru majoritatea firmelor din România, site-ul este un instrument de vânzare, nu un produs în sine. Paginile de servicii, prezentarea firmei și studiile de caz există ca să fie găsite. Pentru aceste firme, permiterea crawlerelor de căutare are sens. Clientul care caută un furnizor ar trebui să vă poată găsi.
Situația diferă când conținutul este chiar valoarea firmei. Ghidurile tehnice detaliate, analizele de piață sau bazele de cunoștințe scrise în română cer timp și bani. Aici blocarea Google-Extended limitează folosirea lor pentru modelele Gemini, fără efect asupra Google Search.
Decizia aparține conducerii, nu doar celui care administrează site-ul. Scrieți-o într-un document scurt: ce crawlere permiteți, ce crawlere blocați și de ce. Așa, la un redesign sau la o schimbare de găzduire, regulile nu se pierd.
Amintiți-vă și limita de fond. Robots.txt este respectat de Googlebot și de crawlerele de încredere, nu de toate. Pentru datele clienților și documentele interne, protecția reală rămâne autentificarea cu parolă pe server.
Pașii următori: verificați robots.txt și decideți pentru fiecare crawler
Puteți parcurge pașii de mai jos singur, în ordinea dată, înainte să schimbați ceva pe site:
- Deschideți fișierul robots.txt de la rădăcina domeniului și notați ce grupuri User-agent conține.
- Împărțiți paginile în două liste: conținut care trebuie găsit și conținut pe care vreți să îl protejați.
- Folosiți tabelul de decizie din acest ghid și alegeți regula pentru Googlebot, Google-Extended și Storebot-Google.
- Pentru orice alt crawler AI, adăugați un grup separat, cu numele lui exact.
- Verificați că nu blocați fișierele CSS și JavaScript de care au nevoie paginile.
- Cereți găzduirii să confirme că firewall-ul și restricțiile pe IP nu resping crawlerele pe care le-ați permis.
- Verificați jurnalele serverului după modificare.
Accesul crawlerelor este doar prima condiție pentru a apărea în răspunsurile AI. A doua este ca paginile să fie clare, structurate și ușor de citat. Pasul firesc după acest ghid este să citiți ghidul nostru despre citarea în Google AI Overviews și să verificați site-ul după lista de acolo.